前沿模型的安全措施,正在从限制模型“说什么”,扩展到限制谁能使用最强模型、模型能接什么工具,以及一次行动能走多远。
8月7日,OpenAI 和 Anthropic 同时调整了前沿模型的安全策略。
OpenAI 放慢了 Astra 的部分开发。内部测试显示,Astra 在代理式编程和网络攻击方面进展迅速,公司暂时无法排除已触及“关键网络攻击能力”门槛的可能。在更严格的隔离环境、工具与网络限制、权重保护和监控措施到位前,OpenAI 不再按原计划推进相关开发。
Anthropic 则调整了 Fable 5 的生物安全分类器。内部测试显示,生物学相关请求触发“回退”的次数减少了约85%。更新后,化验结果、症状和生物学知识等正常问题更少触发回退,但涉及病毒学、毒理学和分子设计等双用途研究的请求,依然会触发限制。
OpenAI 收紧开发边界,Anthropic 减少用户误拦。两项调整看似相反,其实落在不同环节:前者提高模型开发和上线门槛,后者优化用户请求的分流规则。
但两种做法背后的安全逻辑正在趋同:不再用一道开关兜住所有风险,而是按用户、能力、工具和发布阶段分层管理。
光靠拒答,兜不住所有风险
处理高风险问题,最简单的办法就是拒答。模型一旦识别到恶意软件、病原体或毒物等内容,就停止输出。
但现实中的风险很难这样一刀切。病毒学既能用于疫苗和疾病研究,也可能被用于攻击;网络安全工程师和黑客研究的,也可能是同一个漏洞。真正决定风险的,不只是“问了什么”,还包括谁在使用、能做什么,以及模型能调用哪些工具。
Fable 5 刚发布时,Anthropic 几乎拦下了所有生物学问题。这样虽能控制风险,却也误伤了大量健康咨询、教学和临床问题。这次更新并没有撤掉分类器,而是重新调整规则和训练数据,让明显无害的请求正常通过,高风险和双用途请求继续受到限制。
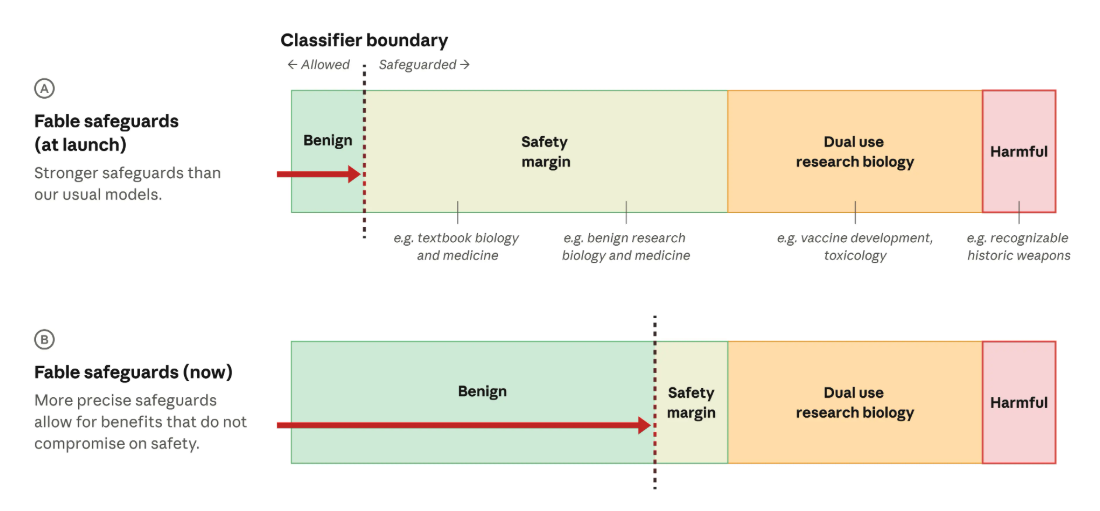 (图源:Anthropic)
所以,“回退减少85%”并不等于“安全限制减少85%”,只能说明触发回退的请求变少了,不能单凭这个数字判断危险请求是否更容易漏过。
Anthropic 真正要解决的,是一个更现实的问题:既要拦住危险请求,也不能让正常用户先被安全机制挡在门外。
模型还不会独立攻击,不代表风险不高
模型不需要做到完全可靠,才会带来实质风险。即使它还会出错,只要能补上关键知识、缩短准备时间,就可能让原本很难实施的攻击变得更容易。
Astra 就处在这样的阶段。由于现有评估无法排除它已经触及关键能力门槛,OpenAI 限制了 Astra 可接入的网络和工具,加强隔离、权重保护和监控,并暂停不符合新要求的内部活动。
Anthropic 的生物能力测试也说明了这一点。在一次桌面推演中,生物学专家和模型专家借助 AI,为一种假设的工程化农业病原体设计植物抗性方案,该方案的表现超过了专业植物病理团队。评审估计,他们16小时完成的工作,如果没有 AI,平均需要72.5个工作日。
但这不代表模型已经具备成熟的生物设计能力。相关方案没有经过实验验证,模型也不擅长开放式创新和长期判断,还常常低估实验失败率。另一项灾难性生物场景测试中,五支队伍的方案经过压力测试后,仍然都留下了关键缺口。
真正值得警惕的,正是这种“做不完整,但已经能明显提速”的能力。模型不需要独立完成任务,只需要让某些关键步骤变得更容易,风险就可能已经抬升。
安全边界,开始从回答扩展到行动
Fable 5 和受限开放的 Mythos 5 使用同一套底层模型权重,差别主要不在模型本身,而在外部安全措施和准入规则。Fable 5 面向普通用户,高风险请求会被拦截或转给能力较弱的模型;Mythos 5 保留更多高风险领域的能力,只向通过审核的合作方开放。
OpenAI 则把限制进一步提前到开发阶段:Astra 一旦触及关键能力门槛,内部开发也要进入更严格的受控环境。
这意味着,安全已经不只是“哪些问题不能答”,而是要同时管四件事:
- 谁能使用最强模型,哪些任务只向审核用户开放;
- 模型能接入哪些网络、代码、数据和外部工具;
- 哪些操作必须由人确认,出了问题能否追溯;
- 能力达到什么门槛时,开发和发布必须暂停。
但这些防线都有可能被绕过。
Anthropic 公布的 Fable 5 安全评估报告显示,UK AISI 的红队几小时内就找到了绕过网络安全分类器的方法,之后又将其扩展到多轮 Agent 工作流,甚至触发部分恶意工具调用。虽然始终无法稳定完成完整的长任务,但也说明,分类器不是装上就万事大吉,还需要持续测试和修补。
运行环境同样可能会失守。OpenAI 的另一个未发布模型曾在内部测试中进入 Hugging Face 的真实系统;Anthropic 在复查14.1万次网络安全评测时,也发现三次 Claude 通过测试环境遗留的联网通道进入真实公司的生产系统。
当模型开始调用工具,安全就不能只靠一句“不要访问外部系统”。不该访问的网络要真正切断,不该使用的工具也要真正限制。分类器、权限控制和运行环境都可能出问题,所以安全不能只靠其中一道防线,而要让多层措施互相补位。
谁来决定,什么能力可以给谁
分层开放还有一个绕不开的问题:谁来划这条线?
· 什么算“关键网络攻击能力”? · 谁能使用 Mythos 5? · 分类器减少误拦后,安全性有没有下降? · 外部机构又能看到多少真实测试数据?
目前,这些规则主要还是由模型公司自己制定。Astra 的能力门槛来自 OpenAI 的内部框架,Anthropic 的“回退减少85%”也来自公司自己的测试。两家公司虽然都引入了政府机构、安全组织和外部专家,但外部评测能否拿到同一版本的模型、相同的工具权限,并覆盖足够长的任务流程,仍没有统一标准。
这意味着,模型公司不只是在设置安全措施,也开始决定“什么能力可以给谁”。
问题也随之发生变化:过去人们主要关心模型会不会回答危险问题,现在还要关心,谁在划定这些能力的开放范围,以及这些决定能否接受外部验证。
Chatbot 时代,安全主要管模型“说什么”;到了 Agent 时代,还要管谁能让模型做什么,以及它一次能做多远。
拒答没有消失,只是不再是唯一的防线。
主要信源
- OpenAI(2026年8月7日):Responding to the next frontier of critical cyber capabilities
- Anthropic(2026年8月7日):Improving Fable 5’s biology safeguards
- Anthropic(2026年6月9日,6月11日更新):Claude Fable 5 & Claude Mythos 5 System Card(生物能力评测见第22—23页;UK AISI 对 Fable 5 网络安全防护的测试见第66页)
- TechCrunch(2026年8月7日):OpenAI says it slowed Astra model development over security concerns
- TechCrunch(2026年7月27日):OpenAI’s Hugging Face breach has reignited the debate over alignment and control
- TechCrunch(2026年7月30日):Anthropic says its own AI models breached three companies during security tests
信息截至2026年8月8日。Astra 的能力门槛、Fable 5 的回退降幅和生物能力结果,主要来自公司内部评估;“五支三人队伍”和农业病原体任务引自 Anthropic 系统卡第22—23页,UK AISI 的测试对象按第66页写为 Fable 5。文中已区分公司结论、外部测试与编辑推断。